Differenza tra Unicode e ASCII Spiegata in Modo Semplice
Ogni volta che scrivi una “à” su una tastiera italiana, il tuo computer sta traducendo quel tasto in un numero che un altro dispositivo, dall’altra parte del mondo, deve saper interpretare esattamente allo stesso modo. Questo è, in sintesi, il problema che ASCII e Unicode risolvono: entrambi sono standard di codifica del testo, ma nascono a distanza di trent’anni l’uno dall’altro e coprono esigenze molto diverse. ASCII gestisce appena 128 caratteri, mentre Unicode ne copre oltre 149.000, includendo alfabeti, emoji e simboli tecnici di ogni sistema di scrittura al mondo.
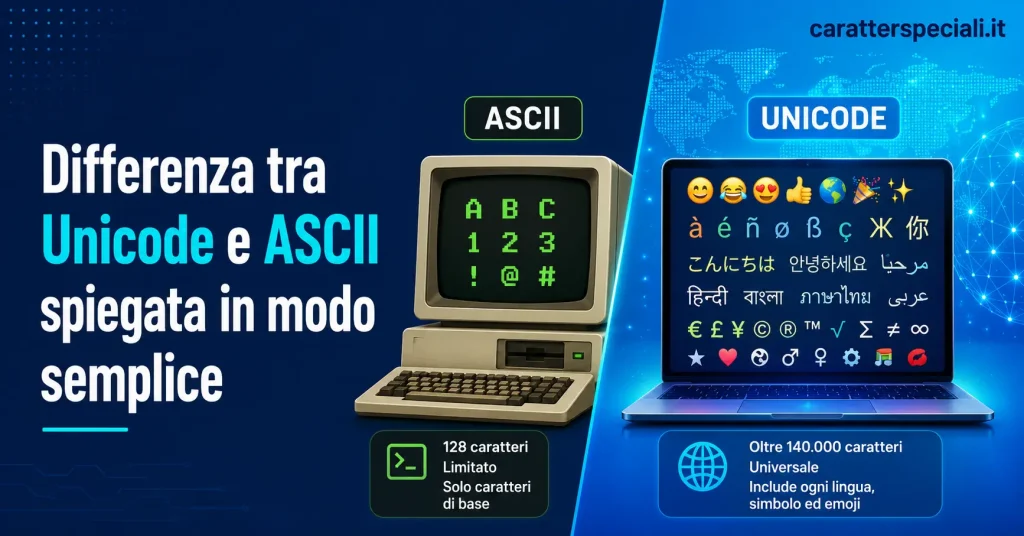
In questa guida spieghiamo la differenza tra Unicode e ASCII in modo semplice, senza tecnicismi inutili, con esempi concreti su perché l’italiano — e qualsiasi lingua con accenti — aveva bisogno di uno standard più ampio di quello nato negli Stati Uniti negli anni ’60.
Cos’è ASCII
ASCII (American Standard Code for Information Interchange) è uno standard di codifica sviluppato nel 1963 e finalizzato nel 1968 dall’American National Standards Institute. Assegna un numero da 0 a 127 a ciascun carattere: le lettere maiuscole e minuscole dell’alfabeto inglese, le cifre da 0 a 9, i segni di punteggiatura di base e alcuni caratteri di controllo (come l’invio a capo).
Il limite è già nel nome: è uno standard americano, pensato per l’inglese. Con soli 128 valori disponibili (7 bit di informazione), ASCII non ha spazio per lettere accentate, alfabeti non latini o simboli matematici avanzati.
Intervallo | Contenuto | Esempio |
|---|---|---|
0–31 | Caratteri di controllo | Invio a capo, tabulazione |
32–64 | Spazio, punteggiatura, cifre | ! ” # $ % & 0-9 |
65–90 | Lettere maiuscole | A-Z |
97–122 | Lettere minuscole | a-z |
123–127 | Simboli residui | { | } ~ |
Un derivato noto è l’Extended ASCII (o ASCII a 8 bit), che sfrutta i valori da 128 a 255 rimasti liberi per aggiungere alcuni caratteri accentati. Il problema è che esistono decine di varianti diverse di Extended ASCII (una per l’Europa occidentale, una per il cirillico, e così via), e non sono compatibili tra loro: lo stesso numero può rappresentare simboli completamente diversi a seconda della tabella usata. Questo caos è stato uno dei motivi principali che ha portato alla nascita di Unicode.
Cos’è Unicode
Unicode è uno standard internazionale di codifica del testo nato nel 1991 con l’obiettivo dichiarato di assegnare un numero univoco — chiamato code point — a ogni carattere di ogni sistema di scrittura esistente al mondo, indipendentemente dalla piattaforma, dal programma o dalla lingua. Oggi, con la versione 16.0, Unicode copre oltre 149.000 caratteri: alfabeto latino esteso, cirillico, arabo, ebraico, cinese, giapponese, coreano, simboli matematici, frecce, emoji e molto altro.
A differenza di ASCII, Unicode non è un singolo formato di byte, ma uno spazio di numerazione. Il modo in cui questi numeri vengono effettivamente salvati nei file o trasmessi in rete dipende dalla codifica scelta, di cui la più diffusa è UTF-8.
Come Funziona la Codifica UTF-8
UTF-8 è la codifica Unicode più usata al mondo — alla base di oltre il 98% delle pagine web secondo i dati storici di W3Techs — perché è retrocompatibile con ASCII: i primi 128 caratteri Unicode corrispondono esattamente ai 128 caratteri ASCII, occupando un solo byte. I caratteri al di fuori di questo intervallo, come le lettere accentate o gli emoji, vengono codificati usando da 2 a 4 byte.
- 1 byte → caratteri ASCII originali (A-Z, 0-9, punteggiatura base)
- 2 byte → lettere accentate e alfabeti come il greco o il cirillico (à, è, ñ, α, б)
- 3 byte → la maggior parte dei caratteri cinesi, giapponesi e coreani
- 4 byte → emoji e simboli meno comuni (🎉, caratteri storici, notazione musicale)
Questo design intelligente è il motivo per cui un vecchio file di testo scritto in puro ASCII resta leggibile anche se aperto come UTF-8: i byte coincidono perfettamente.
Unicode vs ASCII: Tabella di Confronto
Caratteristica | ASCII | Unicode (UTF-8) |
|---|---|---|
Anno di nascita | 1963 | 1991 |
Caratteri supportati | 128 (7 bit) | oltre 149.000 |
Lingue coperte | Solo inglese | Quasi tutte le lingue del mondo |
Emoji e simboli avanzati | Non supportati | Supportati nativamente |
Compatibilità tra piattaforme | Limitata, versioni multiple | Universale (standard unico) |
Spazio occupato per carattere | 1 byte fisso | 1-4 byte variabili (UTF-8) |
Uso attuale sul web | Praticamente in disuso da solo | Standard predefinito (oltre 98% dei siti) |
Perché ASCII Non Basta per l’Italiano
L’italiano usa lettere accentate come à, è, é, ì, ò, ù, oltre a simboli come l’euro (€) o le virgolette basse (« »), nessuno dei quali rientra nei 128 caratteri ASCII originali. Un testo italiano salvato in puro ASCII perderebbe questi caratteri o li sostituirebbe con simboli errati — un problema molto comune nelle email o nei file di vecchi sistemi gestionali che non gestiscono correttamente la codifica.
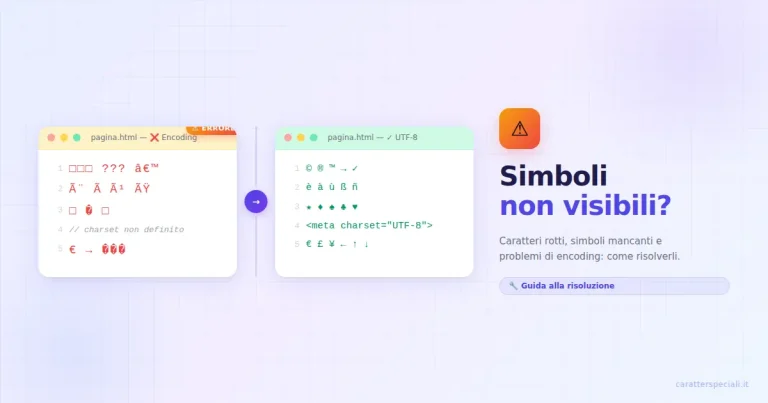
Questo è esattamente il tipo di errore che genera testo “corrotto” (i famosi caratteri come è al posto di è), un fenomeno noto come mojibake, causato da un file scritto in una codifica e letto con un’altra. Unicode, e in particolare UTF-8, elimina il problema alla radice perché offre una rappresentazione univoca e universale per ogni lettera accentata, indipendentemente dal sistema operativo o dal software usato.
Un Breve Sguardo Storico: Dal Telegrafo a Unicode
Prima ancora di ASCII, i sistemi di comunicazione digitale usavano codifiche ancora più limitate, come il codice Baudot a 5 bit usato nei telescriventi, capace di rappresentare appena 32 simboli. ASCII, arrivando negli anni ’60 con i suoi 128 caratteri, fu un salto enorme in avanti, ma restava comunque legato a un solo alfabeto.
Negli anni ’80, con la diffusione dei personal computer in tutto il mondo, il problema della frammentazione delle codifiche divenne evidente: ogni paese, o quasi, aveva la propria variante di Extended ASCII, incompatibile con le altre. Il consorzio Unicode, fondato nel 1991 da ingegneri di aziende come Xerox e Apple, nacque proprio per porre fine a questa Babele digitale, con l’obiettivo — oggi in gran parte raggiunto — di avere un solo standard capace di rappresentare qualunque lingua scritta al mondo, dal latino al cinese, dal cirillico agli antichi geroglifici egizi inclusi nelle versioni più recenti dello standard.
Domande Frequenti
Unicode ha sostituito completamente ASCII?
Non esattamente: Unicode, tramite la codifica UTF-8, include ASCII al suo interno come sottoinsieme. I 128 caratteri ASCII originali corrispondono esattamente ai primi 128 code point Unicode, quindi ogni testo ASCII è automaticamente anche un testo UTF-8 valido.
Perché esistono UTF-8, UTF-16 e UTF-32?
Sono tre modi diversi di salvare gli stessi code point Unicode in memoria. UTF-8 usa da 1 a 4 byte variabili ed è il più efficiente per il web e le lingue occidentali; UTF-16 usa 2 o 4 byte ed è usato internamente da sistemi come Windows e Java; UTF-32 usa sempre 4 byte fissi ed è meno comune per il suo maggiore consumo di memoria.
Come faccio a sapere se un file usa ASCII o Unicode?
Nella maggior parte degli editor di testo moderni (Notepad++, VS Code, Word) puoi controllare o cambiare la codifica dal menu in basso o dalle opzioni di salvataggio. Se un file contiene solo lettere inglesi e numeri, tecnicamente potrebbe essere sia ASCII sia UTF-8: la differenza emerge solo quando compaiono caratteri accentati, emoji o simboli speciali.
Conclusione
La differenza tra Unicode e ASCII, in sintesi, è la differenza tra uno standard nato per 128 caratteri dell’inglese scritto a macchina e uno standard pensato per rappresentare ogni sistema di scrittura umano, comprese le migliaia di simboli, emoji e alfabeti che usiamo oggi online. ASCII resta importante da conoscere perché è ancora alla base tecnica di UTF-8, ma per qualsiasi uso moderno, email, siti web, app, social media — Unicode è lo standard di riferimento, l’unico in grado di garantire che un simbolo scritto su un dispositivo appaia identico su tutti gli altri.
Vuoi vedere i caratteri Unicode in azione? Prova il nostro generatore di caratteri speciali e scopri oltre 300 stili di font basati proprio su questo standard.